Open source ou open weights : quelle est la véritable ouverture de votre modèle d’IA ?
Par L'équipe Web à Lille
Publié le novembre 9, 2026
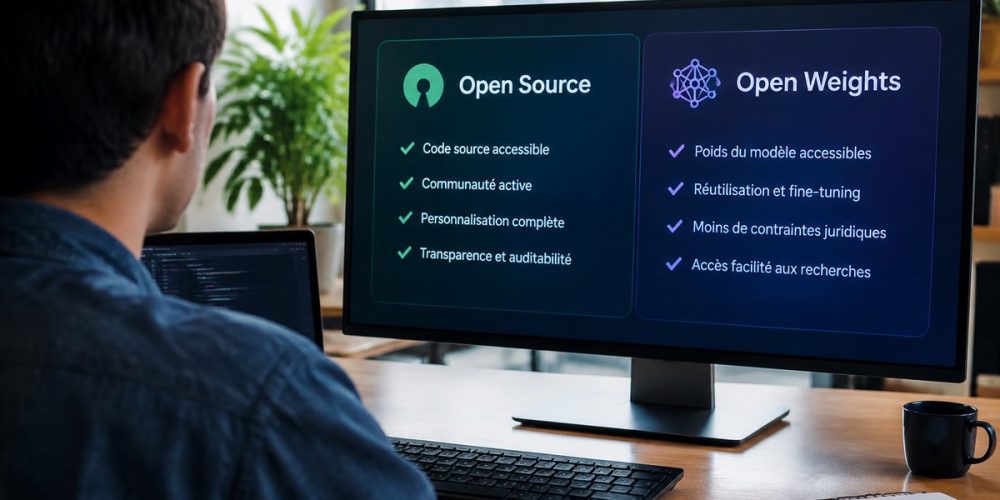
Le terme « open source » est souvent galvaudé lorsque l’on parle de modèles d’intelligence artificielle (IA). Les éditeurs ont tendance à assimiler cette notion à la mise à disposition des « poids » de leurs modèles. Cependant, selon l’Open Source Initiative (OSI), la véritable ouverture requiert bien plus que cela, notamment des informations sur les données et le code d’entraînement. Alors, qu’est-ce qui différencie réellement un modèle d’IA ouvert des autres ?
L’essentiel à retenir
- La publication des « poids » d’un modèle d’IA ne garantit pas une véritable ouverture selon l’OSI.
- Pour être considéré comme « open source », un modèle doit permettre l’étude, la modification, l’utilisation et le partage, en incluant les données et le code d’entraînement.
- La réglementation européenne AI Act impose des obligations spécifiques aux fournisseurs de modèles d’IA, avec certaines exemptions pour les modèles ouverts.
Imaginez que vous êtes un développeur désireux de comprendre et d’améliorer un modèle d’IA. Vous téléchargez les « poids » de ce modèle, espérant pouvoir l’étudier et l’adapter à vos besoins. Cependant, sans accès aux données d’entraînement et au code source, votre tâche devient presque impossible. Cette expérience est partagée par de nombreux développeurs qui, comme vous, espèrent qu’un jour, l’étiquette « open source » sera utilisée dans son sens le plus complet.
La distinction entre open source et open weights
De nombreux modèles d’IA, comme Llama ou gpt-oss d’OpenAI, sont souvent présentés comme « open source » simplement parce que leurs poids sont téléchargeables. Pourtant, selon l’OSI, cela ne suffit pas. Un modèle véritablement « open source » doit inclure des informations détaillées sur les données et le code d’entraînement. En 2024, l’OSI a publié l’OSAID, une définition de l’IA open source, qui impose ces exigences pour garantir une ouverture complète.
Les critères de l’OSAID et les attentes de l’Open Source Initiative
La définition OSAID de l’OSI repose sur quatre libertés fondamentales : utiliser, étudier, modifier et partager. Pour qu’un modèle soit conforme, il doit fournir des informations complètes sur les données, le code et les paramètres. Cela inclut la provenance des données, leur sélection, leur étiquetage, ainsi que le code d’entraînement. Un modèle ne peut être considéré comme « open source » que s’il permet une reconstruction complète et une auditabilité totale.
L’impact du règlement européen AI Act sur les modèles d’IA
Depuis août 2025, le règlement européen AI Act impose plusieurs obligations aux fournisseurs de modèles d’IA, notamment en termes de documentation technique et de politique de respect du droit d’auteur. Cependant, une exemption est prévue pour les modèles ouverts. Ces derniers ne sont pas soumis à certaines obligations, à condition que leur licence soit libre et que les poids, l’architecture et les informations d’utilisation soient publics.
Les modèles français et européens : une ouverture en progression
Les modèles européens, tels qu’Apertus et Luciole, montrent une volonté croissante de transparence. Sous licence Apache 2.0, ils publient non seulement les poids, mais aussi des informations détaillées sur les données et le code d’entraînement. Cependant, les pratiques varient, et tous les modèles ne documentent pas leurs données de la même manière. En France, des initiatives comme OpenLLM-France s’efforcent de renforcer cette ouverture.
Open source dans le secteur de l’IA : vers une adoption plus large ?
En 2026, la question de l’ouverture des modèles d’IA reste au cœur des débats. Des entreprises telles que Mozilla et Hugging Face militent pour une transparence accrue, espérant que davantage de modèles suivront les directives de l’OSAID. Cependant, de nombreux acteurs du marché restent réticents, craignant que la divulgation complète de leurs modèles ne compromette leurs avantages concurrentiels.
La réglementation et les enjeux éthiques dans l’IA
La régulation de l’IA ne se limite pas aux questions de transparence et d’ouverture. Des organisations comme la Commission européenne travaillent activement à encadrer l’utilisation de l’IA pour éviter les biais et les discriminations. Des figures comme Margaret Mitchell, cofondatrice de l’équipe d’éthique de l’IA chez Google, soulignent l’importance de l’éthique dans le développement de l’IA.
FAQ sur l’ouverture des modèles d’IA
Quelle est la différence entre « open weights » et « open source » pour un modèle d’IA ?
« Open weights » signifie que les paramètres du modèle sont disponibles en téléchargement, mais cela ne garantit pas l’accès au code source ou aux données d’entraînement nécessaires pour une véritable ouverture « open source ».
Quels sont les critères de l’OSAID pour qu’un modèle soit considéré comme open source ?
Un modèle doit permettre l’utilisation, l’étude, la modification et le partage, tout en fournissant des informations sur les données, le code et les paramètres d’entraînement.
Comment le règlement AI Act affecte-t-il les modèles d’IA ouverts ?
Le règlement AI Act impose des obligations aux fournisseurs de modèles d’IA, mais prévoit des exemptions pour les modèles ouverts, à condition que certaines informations soient rendues publiques.
Existe-t-il des modèles d’IA français conformes à l’OSAID ?
Oui, des modèles comme Luciole tentent de se conformer aux critères de l’OSAID, bien que l’OSI ne certifie pas officiellement les modèles.